Většina startupů a firemních inovací zkrachuje ne proto, že by jejich nápad byl špatný, ale protože se utopí v technických detailech. Zakladatelé často stráví měsíce nastavováním serverů, řešením licencí a kupováním hardwaru, aniž by si vůbec ověřili, zda produkt někdo chce. Přitom dnešní cloudové technologie umožňují spustit funkční prototyp za dny, ne měsíce. Klíč je v tom, nepostavit si vlastní datové centrum, ale využít služeb, které jsou připravené k použití.
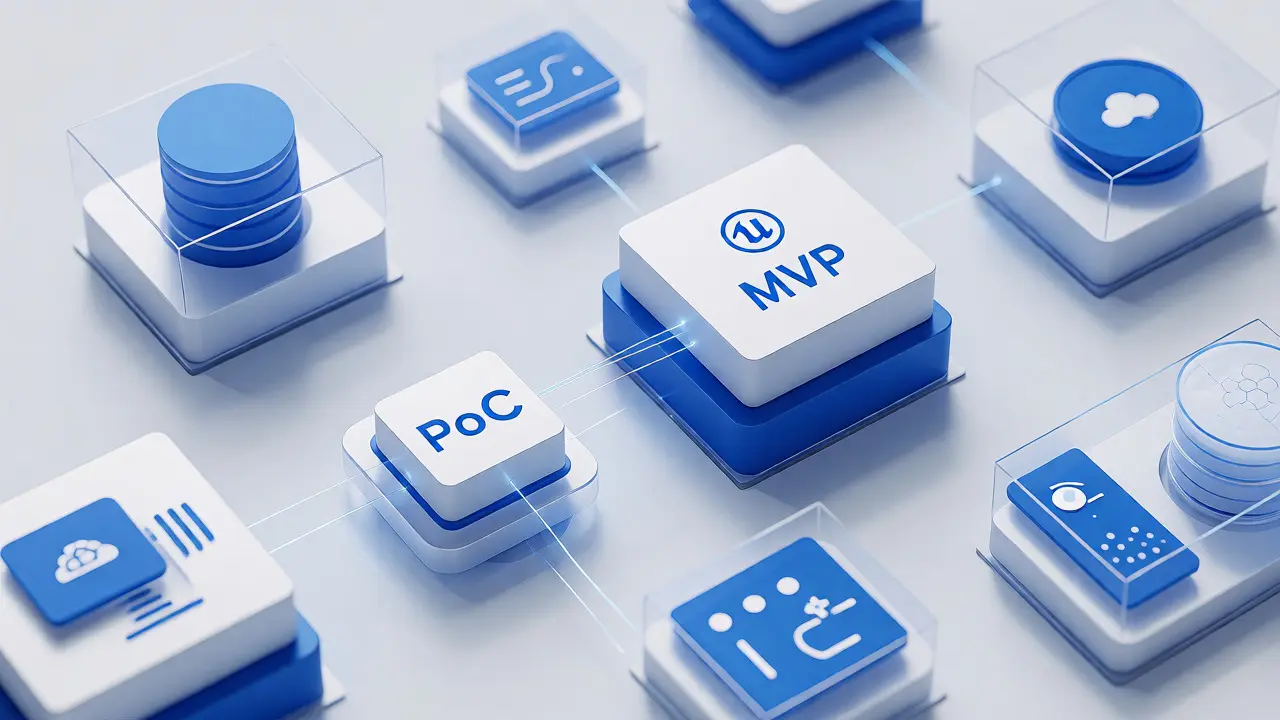
PoC (Proof of Concept) a MVP (Minimum Viable Product) jsou dvě různé fáze vývoje, které se často zaměňují. PoC je důkaz, že technicky něco jde udělat - třeba že dokážete zpracovat milion transakcí za sekundu nebo propojit dvě nestandardní databáze. MVP je první verze produktu, kterou už může použít reálný zákazník a která vám dá zpětnou vazbu. Oba kroky vyžadují infrastrukturu, ale rozhodně ne tu, kterou byste nasadili na produkci s tisíci uživateli.
Rozdíl mezi PoC a MVP: Co vlastně potřebujete?
Při stavbě PoC vás nezajímá škálovatelnost do budoucna. Zajímá vás jen jeden úzký scénář. Pokud chcete ověřit, zda umíte napojit AI model na e-shop, stačí vám jeden malý server nebo serverless funkce. Nepotřebujete load balancer, který vydrží výpadky, ani replikaci databází na třech kontinentech. Naopak u MVP už musíte myslet na to, aby aplikace nespadla při prvních deseti platících uživatelích. Zde už vstupuje do hry stabilita a základní monitoring.
Častou chybou je snaha postavit rovnou "produkční-grade" architekturu. Tým nakoupí předplatné enterprise služeb, nastaví Kubernetes cluster s deseti uzly a zapne složité CI/CD pipeline pro deploy, i když má aplikaci jen dva vývojáři. Výsledkem je vysoká měsíční faktura od cloud providera a nízká rychlost iterací. Každá změna trvá hodiny kvůli složitosti nastavení, nikoliv kvůli samotnému kódu.
Jak vybrat správnou cloudovou infrastrukturu pro rychlý start
Pro rychlé ověření nápadu se nejčastěji využívají tři přístupy, lišící se mírou abstrakce a kontrolou nad prostředím. Volba závisí na tom, jak moc specifikace vašeho PoC nebo MVP vybočuje ze standardních šablon.
| Oblast | Serverless / PaaS | Kontejnery (Docker/K8s) | IaaS (Virtuální stroje) |
|---|---|---|---|
| Rychlost nasazení | Minuty až hodiny | Hodiny až dny | Dny až týdny |
| Správa OS | Žádná (poskytovatel řeší vše) | Střední (správa image, orkestrace) | Vysoká (patching, security) |
| Náklady při nulovém provozu | Blízké nule | Stálé (běžící node) | Stálé (běžící VM) |
| Vhodnost pro PoC | Ideální pro API, web, event-driven | Vhodné pro specifické knihovny, GPU | Nutné pro legacy systémy, custom HW |
Pro většinu moderních webových a mobilních aplikací je volbou číslo jedna PaaS (Platform as a Service) nebo serverless architektury. Služby jako Azure App Service, AWS Lambda nebo Google Cloud Run starost o operační systém zcela eliminují. Vy nahrajete kód, on běží. Neřešíte, kdy aktualizovat Linux, neřešíte bezpečnostní záplaty jádra. To vám ušetří desítky hodin práce, které byste jinak věnovali sysadminovi.
DevOps principy, které ušetří peníze ještě před spuštěním
Slovo DevOps zní často jako buzzword pro velké korporáty, ale jeho základy jsou pro malé týmy klíčové. Největším zabijákem rozpočtu u PoC není cena serveru, ale lidská práce. Pokud každý deploy znamená ruční upload souborů přes FTP nebo manuální editaci konfiguračních souborů na serveru, jste pomalí a chyboví.
Prvním krokem by mělo být automatické nasazování pomocí jednoduchého skriptu nebo GitHub Actions. Druhým krokem je Infrastructure as Code (IaC). I pro malý projekt se vyplatí mít definici infrastruktury v Terraformu nebo Bicepu. Proč? Protože když PoC selže, jedním příkazem `terraform destroy` vymažete všechno a zastavíte všechny poplatky. U manuálně nastavených serverů se stává, že po projektu zůstane běžet pár "zapomenutých" instancí, které měsíce čerpají kredit.
Třetí zásadou je izolace prostředí. Nikdy netestujte na produkční databázi, i když je MVP malá. Použijte levnější instance pro dev/test prostředí. Cloud provideri často nabízejí spotové instance (spot instances), které jsou až o 90 % levnější než běžné virtuální servery, protože jdou pryč, když je provider potřebuje jinde. Pro testovací prostředí je to ideální kompromis.
Kdy potřebujete externí pomoc a kdy ne?
Mnoho zakladatelů váhá, zda si najmout specialistu na cloud, nebo to zvládnout sami. Obecné pravidlo zní: pokud váš tým nemá nikoho, kdo by měl zkušenosti s nasazováním na cloud mimo lokální notebook, investujte do konzultace. Ne nutně do plného úvazku, ale alespoň do auditu návrhu architektury.
Zde vstupuje na scénu specializované firmy, které se zabývají právě touto oblastí. Například pražský tým Vesmus se specializuje na full-cycle DevOps a cloud-native poradenský servis. Jejich přístup spočívá v tom, že infrastrukturu staví jako kód přímo v repozitáři klienta. To znamená, že klient zůstává majitelem svého nastavení a není uvězněn v proprietary nástrojích dodavatele. Pro startupy je tato transparentnost kritická - pokud firma roste, musí být schopna převzít správu infrastruktury interně nebo ji předat dalšímu partnerovi bez bolestivého migračního procesu.
Tým Vesmus pracuje s主流ními platformami jako Azure, AWS nebo Google Cloud a používá standardní nástroje jako Terraform, Ansible nebo Kubernetes. Cílem není vytvořit komplexní ekosystém, který bude udržovat jen sám dodavatel, ale takovou infrastrukturu, na kterou během roku skoro nemyslíte. To je podle nich znakem dobré infrastruktury. Pro PoC a MVP to znamená, že se soustředí na minimální potřebnou konfiguraci, která umožňuje rychlé iterace, ale zároveň je připravena na pozdější rozšíření bez totálního refaktoringu.
Typické pasti při budování MVP na cloudu
Nejčastější chyba je podcenění datových transferů. Můžete mít levný server, ale pokud přenášíte gigabajty dat mezi regiony nebo mezi cloudem a on-premise systémem, účty za egress (odchozí data) mohou překonat náklady na výpočetní výkon. Před podpisem kontraktu si vždy promyslete, odkud kam data tečou.
Druhou pastí je předčasné optimalizování. Není nutné hned na začátku řešit autoscaling na miliony požadavků. Stačí pevně daný počet instancí, který zvládne očekávanou zátěž prvního měsíce. Složitější nastavení přidávejte až ve chvíli, kdy máte reálná data o chování uživatelů. Jinak budete ladit parametry pro zátěž, která nikdy nenastane.
Třetí problém je bezpečnost. I u MVP nelze ignorovat základní zabezpečení. Otevřená portová databáze na celém internetu je riziko i pro demo. Použijte firewall rules, které povolí přístup pouze z IP adres vašeho týmu nebo API gatewaye. Většina cloudových platforem má tyto funkce vestavěné a aktivace stojí minuty.
Checklist pro spuštění PoC/MVP bez bolavé hlavy
- Definujte metriku úspěchu: Jak poznáte, že PoC funguje? Je to latence pod 100 ms? Nebo zpracování 1000 objednávek denně? Bez jasné metrikы se budete topit v detailech.
- Vyberte managed služby: Pokud nepotřebujete specifickou verzi PostgreSQL, použijte RDS nebo Azure Database for PostgreSQL. Správa záloh, patchování a HA je pak starostí providera.
- Nasazujte automatizovaně: Nastavte CI/CD pipeline tak, aby push do main branch automaticky nasadil novou verzi do staging prostředí.
- Mějte backdoor pro monitoring: Zapněte základní logování a metriky (CPU, RAM, error rate) od prvního dne. Bez dat nebudete vědět, proč aplikace zpomalila.
- Plánujte ukončení: Pokud PoC selže, víte, jak rychle vypnout vše a smazat data? Máte IaC skripty, které to umí?
Rychlost ověření nápadu dnes není otázkou technické vyspělosti, ale disciplíny. Vyhnout se zbytečné složitosti, využívat abstrakce, které cloud nabízí, a mít jasný plán pro odchod, pokud projekt nedosáhne cílů. To jsou pilíře, na kterých stojí úspěšné MVP. Ať už to děláte sami, nebo s podporou expertů z oblasti DevOps a cloudu, pamatujte, že infrastruktura je prostředek, ne cíl.
Je lepší začít s AWS nebo Azure pro MVP?
Záleží na vašem tech stacku. Pokud používáte .NET a Microsoft technologie, Azure bude mít nižší bariéru vstupu díky integraci. Pokud preferujete open-source stack (Python, Node.js, Go), AWS má širší portfolio specializovaných služeb. Google Cloud je silný v AI/ML a Big Data. Pro čistě PoC často hraje roli aktuální akční nabídka free tieru nebo startup kreditů, které jednotlivé platformy poskytují.
Kdy mám přestat používat serverless a přejít na Kubernetes?
Přechod na Kubernetes má smysl, když narazíte na limity serverless řešení, například dlouhodobě běžící procesy, potřebu specifických knihoven, které nejsou dostupné v runtime prostředí, nebo když vaše náklady na serverless překročí cenu dedikovaných instancí. Pro většinu MVP je však Kubernetes overkill a zvyšuje operační režii.
Co je Infrastructure as Code a proč ho potřebuji i pro malý projekt?
Infrastructure as Code (IaC) znamená, že vaši infrastrukturu popisujete v textových souborech (např. Terraform, Bicep) místo klikání v grafickém rozhraní cloudového portalu. Pro malý projekt to přináší opakovatelnost - můžete snadno vytvořit identické prostředí pro testování a produkci. Také umožňuje rychlé smazání celé infrastruktury jedním příkazem, což minimalizuje riziko placení za "zapomenuté" zdroje.
Jaké jsou typické náklady na cloudovou infrastrukturu pro MVP?
Náklady jsou extrémně variabilní. Fungující MVP s několika uživateli může stát řádově stovky korun měsíčně, pokud využíváte free tier a menší instance. Jakmile začnete škálovat databáze nebo přidávat více mikroservis, náklady rostou exponenciálně. Klíčové je monitorovat účet denně v prvních týdnech, abyste odhalili neočekávané položky, jako jsou náklady za storage nebo network egress.
Potřebuji pro MVP vlastního DevOps inženýra?
Na úplném začátku obvykle ne. Full-stack vývojář s nějakými zkušenostmi s cloudem často stačí. Externí DevOps specialista se vyplatí ve chvíli, kdy se tým zvětší, nebo když narazíte na problémy s bezpečností, škálovatelností nebo složitostí nasazování, které brzdí vývoj. Konzultace s firmou jako Vesmus může pomoci nastavit správný kurz dříve, než vznikne technický dluh.